DeepSeek V4.1-Flash 1017 是什麼?
便宜、輕量又開源,中國 AI 實驗室改寫前沿模型的成本規則
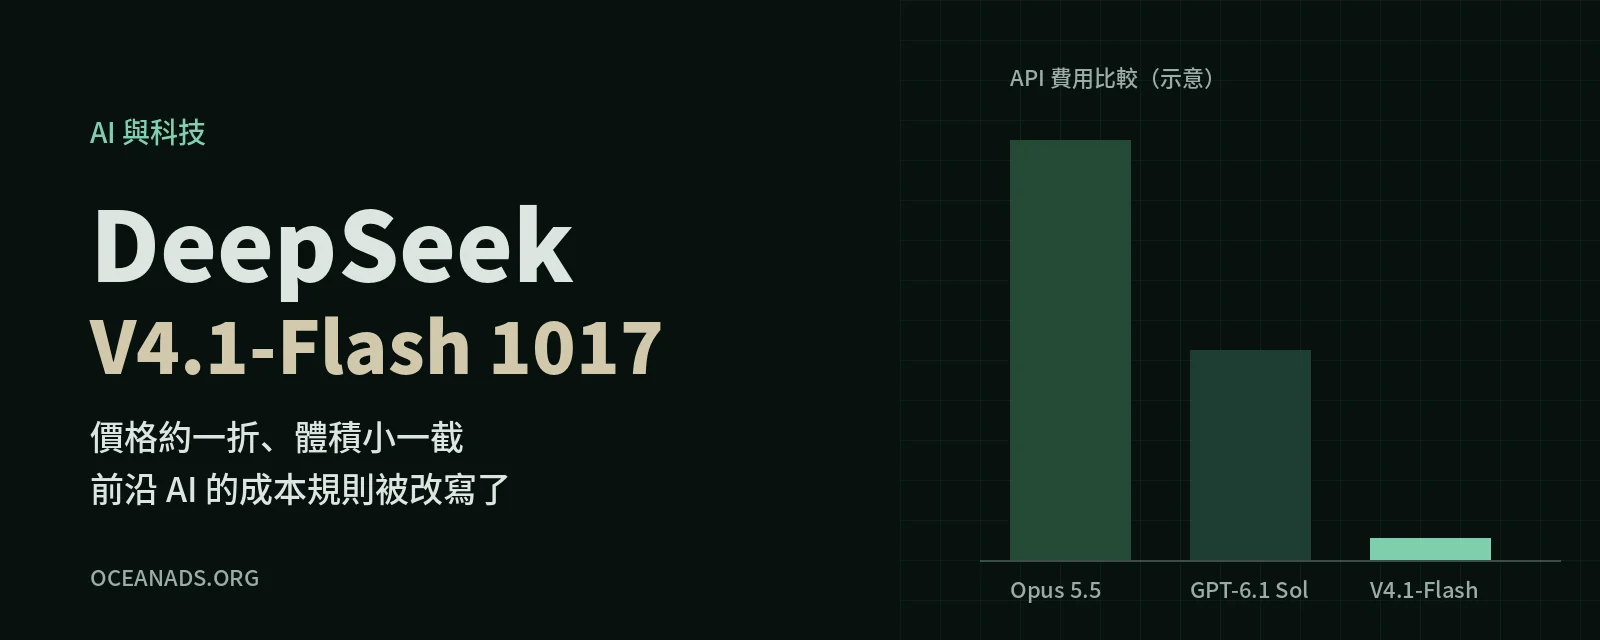
DeepSeek V4.1-Flash 1017 是中國 AI 實驗室 DeepSeek 剛公開的新模型:在程式開發基準 DeepSWE 拿下約 77% 成功率、每個任務約 0.20 美元,API 輸入每百萬 tokens 0.15 美元、輸出 0.3 美元,還同步釋出 763B 參數的開放權重。它不是全面打贏美國前沿模型,但在「性能 × 價格 × 體積」這三件事同時做到,讓整個 AI 產業的成本算法得重新算一次。
這篇文章整理自一位長期重度使用各家模型的日本開發者,在模型公開當下寫的第一手心得。原文情緒很滿——「世界 AI 霸權的平衡被徹底打破」「週一 AI 概念股恐怕不只是大跌」——我們把激動的部分放一邊,把他點出的四個重點拆開來看:性能、價格、體積、做法。每一個單獨拿出來都夠有話題,四個疊在一起,才是真正讓人坐不住的地方。
定義:前沿模型(frontier model)指當下能力最頂尖的一批大型語言模型,例如 Opus 5.5、GPT-6.1 Sol;SOTA(state of the art)指在某項基準測試上達到目前最佳水準;開放權重(open weights)指模型的參數檔案公開下載,任何人都能在自己的機器上部署,不必透過原廠 API。
發生了什麼事
DeepSeek 公開了 V4.1-Flash 1017。V4.1-Flash 本身不是新模型,之前就已經存在,定位是「便宜、性能還不錯」,在開發者圈子裡算是小有人氣,但沒人會拿它跟最頂尖的模型相比。
這次的 1017 版本不一樣。一個中國實驗室,突然丟出一個在部分項目上追平、甚至超越美國前沿模型的版本,而且價格維持在原本那個「幾乎不用錢」的水準。
一、性能:在 DeepSWE 上贏過 GPT-6.1 Sol
先講清楚:它不是每個領域都超越 Opus 5.5。但就整體表現來說,已經可以放進 SOTA 等級的討論裡。
最讓人驚訝的是 DeepSWE 這項基準,它測的是模型實際修改程式碼、完成開發任務的成功率:
| 模型 | DeepSWE 成功率 | 每個任務費用 |
|---|---|---|
| DeepSeek V4.1-Flash 1017 | 約 77% | 約 0.20 美元 |
| GPT-6.1 Sol(最高分設定) | 約 75% | 約 0.65 美元 |
換句話說,在這個比較裡,它只花大約三分之一的費用,成功率還稍微高一點。如果你的工作是大量跑程式實作與修正,這個差距會被放大到很可觀。但比省錢更讓人震撼的,是「成功率超過 Sol」這件事本身。
二、價格:說「幾乎免費」太誇張,但真的很接近
API 定價是輸入每百萬 tokens 0.15 美元、輸出每百萬 tokens 0.3 美元。
以「輸入 10 萬 tokens+輸出 1 萬 tokens」這種常見的開發情境來算,一次大約 0.018 美元,換算新台幣不到 1 元。跟其他模型相比:
- 比 GPT-6.1 Sol 便宜約 86–93%
- 比 Opus 5.5 便宜約 93–97%
而且這還不是全部。原作者提到,搭配 DeepSeek 自家的工具鏈使用時,他自己的輸入快取命中率有時高達 99%,被快取的輸入費用更低,實際花費會比上面的數字再少一截。他的體感是:「大概便宜了 200 倍」。這是個人使用經驗,不是官方數據,但方向很清楚。
他還自嘲:以前確實嚷嚷過「給我一個可以像自來水一樣隨便用的 Opus、Fable」,但沒想到真的有人做到這種程度。
三、體積:763B,家裡就跑得動的前沿模型
這麼強的模型,DeepSeek 同時把開放權重免費公開了。參數量 763B,光是權重檔就大約 510.3GB。
這個數字要放在對照裡看才有感覺。美國前沿模型的參數量從未公開,業界傳言動輒 10T 等級;同樣是開源陣營的 Kimi K3 則是 2.8T。763B 相較之下小了好幾倍。
參數量為什麼重要?因為參數越多,每一次推論需要的運算資源與電力就越多,成本自然越高。美國實驗室的做法,是靠握有大量算力硬推過去;DeepSeek 則是讓模型本身變輕。
輕到什麼程度?原作者推估,4 台 DGX Spark,或一台 512GB 記憶體的 Mac Studio,就有機會把它跑起來。不需要誇張的資料中心,前沿等級的模型也能在辦公室甚至家裡運作。實際速度仍取決於量化方式與推論框架,但「能不能跑」這道門檻已經大幅降低。
四、做法:不是重練,而是把舊模型「調」到前沿
這是整件事最出乎意料的地方。官方說明,1017 版本是拿原本就存在的 V4.1-Flash,用自我回饋的強化學習(RL)做後訓練強化出來的。
細節先不展開,重點是:他們沒有從頭訓練一個更大的模型,而是在既有模型上「事後調整」,就把性能拉到這個等級。
更驚人的是,這次後訓練在提高開發任務成功率的同時,處理時間與輸出量也一起下降。也就是性能變強了,使用者要付的費用反而更少。原作者的反應很直接:「這個進步幅度太誇張,完全看不懂。」
他最後的結論是:我們必須承認,DeepSeek 現在是世界上最優秀的 AI 實驗室之一。
四件事疊在一起,為什麼是大事
單看任何一項,都有前例可循:便宜的模型很多,開源的模型也不少,在單一基準拿高分也不稀奇。真正改變局面的是同時成立:
- 性能夠用:在開發任務上已經跟前沿模型同級。
- 價格極低:每次呼叫的成本降到原本的個位數百分比。
- 體積小、權重公開:可以不經過任何雲端廠商,自己部署。
- 靠後訓練達成:代表「堆算力、堆參數」不再是通往前沿的唯一路線。
第四點對產業的衝擊可能最深。過去幾年,前沿 AI 的護城河被認為是資本與算力;如果後訓練就能讓一個中型模型追上,那條護城河就沒有想像中那麼寬。這也是原作者會擔心 AI 概念股的原因——當然,股價怎麼走沒人說得準,這只是他的個人判斷。
對台灣中小企業意味著什麼
對大多數老闆來說,誰是世界第一的 AI 實驗室並不重要,重要的是:把 AI 放進自己生意裡的成本,又往下掉了一大截。
- AI 客服與自動回覆:以前會擔心「訊息量一大,API 帳單會不會失控」,現在同樣的預算能處理的對話量多了好幾倍。
- 內部文件與資料處理:報價單整理、商品文案初稿、客戶訊息分類這類量大但單價低的工作,更容易算得過來。
- 資料不想出公司:開放權重代表可以在自己的設備上部署,敏感資料不必送到外部 API。對醫療、法律、製造業的客戶資料特別有意義。
但也有幾件事要冷靜看待:
- 基準分數不等於你的任務表現:DeepSWE 測的是程式開發,你的客服、文案、中文語氣表現如何,要自己拿實際案例測。
- 使用原廠 API 時,資料會送到 DeepSeek 的伺服器:有個資或機密疑慮的情境,請先確認服務條款與資料存放地,或改走自行部署。
- 自行部署不是零成本:硬體、電費、維運人力都要算進去,用量不大的話,API 往往還是比較划算。
OceanAds 可以怎麼幫忙
海水不可斗量數位工作室(OceanAds)是位於台中的數位營運系統服務商,協助中小企業把 AI 客服、企業助手與網站自動化串進既有流程。我們不綁定特定模型廠商,會依你的任務、預算與資料敏感度,比較 API 與自行部署的成本,挑出最合適的組合;交付的系統原始碼與帳號都移交給客戶,日後要換模型也不會被卡住。
深度思辨:當聰明變便宜,什麼會變貴
經濟學有個老觀察叫「傑文斯悖論」:十九世紀蒸汽機變得更省煤,英國的煤炭總用量不降反升,因為省下來的成本讓更多人、更多場合開始用蒸汽機。AI 很可能正在重演這一幕。每次呼叫便宜了二十倍,不會讓大家少花錢,而是讓原本「不值得叫 AI 做」的事,全部變成值得。
認知科學裡也有類似的現象。大腦會把稀缺的東西看得更有價值,一旦某樣東西變得隨手可得,我們對它的注意力就會轉移到仍然稀缺的地方。當「產出一段合格的程式碼或文案」幾乎不花錢,稀缺的就不再是產出本身,而是判斷要做什麼、看得出哪個結果是對的。
莊子說「物物而不物於物」,使用工具而不被工具使用。模型會一直變強、變便宜,今天的 1017 版本,明年可能又會被下一個名字取代。追逐每一次發表的分數,很容易讓人覺得自己永遠落後一步;但對經營者來說,真正該問的始終是同一個問題:我的客人需要什麼,而哪一段工作值得交給機器?這個問題的答案,不會因為模型換代而過期。
結論
DeepSeek V4.1-Flash 1017 不是全面打敗美國前沿模型的「神模型」,但它在 DeepSWE 上以約三分之一的費用贏過 GPT-6.1 Sol、API 價格比 Opus 5.5 便宜九成以上、763B 開放權重能在家用等級設備運行,而且是靠後訓練而非重練達成。這四件事加起來,讓「前沿 AI 一定很貴、一定要靠大型資料中心」的前提開始鬆動。
對中小企業來說,最實際的下一步很簡單:挑一個你一直覺得「叫 AI 做太貴」的工作,拿這類低價模型實際測一次,看看帳單與品質是否都過得了關。
常見問題
DeepSeek V4.1-Flash 1017 是什麼?
DeepSeek V4.1-Flash 1017 是中國 AI 實驗室 DeepSeek 在既有 V4.1-Flash 模型上,以自我回饋的強化學習(RL)後訓練強化而成的新版本。它在部分基準上達到前沿模型等級,例如 DeepSWE 成功率約 77%,同時公開 763B 參數的開放權重。
DeepSeek V4.1-Flash 1017 的 API 價格是多少?
輸入每百萬 tokens 0.15 美元、輸出每百萬 tokens 0.3 美元。以輸入 10 萬加輸出 1 萬 tokens 為例,比 GPT-6.1 Sol 便宜約 86–93%,比 Opus 5.5 便宜約 93–97%;若輸入快取命中率高,實際費用還會更低。
DeepSeek V4.1-Flash 1017 可以在自己的電腦上跑嗎?
可以朝這個方向規劃。模型為 763B 參數、權重約 510.3GB,推估 4 台 DGX Spark 或 512GB 記憶體的 Mac Studio 就有機會運行,不必依賴大型資料中心。實際速度與可用性仍取決於量化方式與推論框架。
DeepSeek V4.1-Flash 1017 在所有項目都贏過 Opus 5.5 嗎?
沒有。它並不是全面超越 Opus 5.5,而是在部分基準達到前沿等級,其中以程式開發任務的 DeepSWE 最引人注目。選模型時仍應依自己的實際任務測試,而不是只看單一分數。